上个月帮一个做采购的朋友处理过这事。供应商发来的对账单是 PDF,三十多页,每页一张表。她原来的做法是把 PDF 放大到 200%,一行一行对着敲进 Excel,敲完还要再对一遍。
我说你先试试直接复制粘贴。她试了,粘出来的东西是这样的:所有单元格挤在一列里,数字和品名粘在一起,还得手工拆。这条路走不通。
为什么 PDF 里的表格复制不出格子
PDF 记录的是"这个字画在页面的哪个坐标",不是"这是第几行第几列"。所以复制的时候,软件只能按文字流顺序给你,看着是表格,拿到的是一串文字。
要还原成真正的表格,得靠工具去判断哪些线是框、哪些文字落在同一个格里。这一步做得好不好,直接决定后面要不要手工修。
操作只有四步
- 把 PDF 拖进上传区。单个文件不超过 50MB。
- 选输出格式:Excel、CSV、Markdown 三选一。要接着算的选 Excel,要导进系统的选 CSV,要贴文档的选 Markdown。
- 填页码范围。不填就是全文处理;只想要第 1 到 3 页和第 5 页,写成
1-3,5。 - 点开始处理,等结果,下载。
下载得到的是压缩包,里面按表拆好了文件。一个 PDF 里有几张表,包里就有几个文件,这点比"全塞进一个工作表"要好整理。
页码范围这个功能值得单独说
三十页的对账单,有时候真正要的只有最后那张汇总表。全文跑一遍要等,还容易把页眉页脚识别成表格的一行。
先翻一遍 PDF,记下目标页码,只跑那几页。既快,又少一堆要删的垃圾行。
扫描件不行,得先做别的
这一步很多人卡住:PDF 打开是图片,文字根本选不中。那不是"表格提取失败",是这份 PDF 里压根没有文字层。
得先做 OCR,把图上的字认出来,再谈表格。顺序反了怎么试都不成。
导出之后一定要看这三处
- 跨页的表格:一张表被分成两页,处理完可能变成两个文件,需要手工接起来。表头通常只在第一页有,第二页得补。
- 合并单元格:跨列的表头,还原后往往只有第一格有值,后面是空的。
- 数字格式:千分位逗号、货币符号、百分号,可能被当成文本。看到单元格左上角有小绿三角,就是文本格式,得转成数值才能算。
我的习惯是先看总行数和合计。原文件有合计的,跟导出的对一下,对得上基本就没错行。
推荐工具
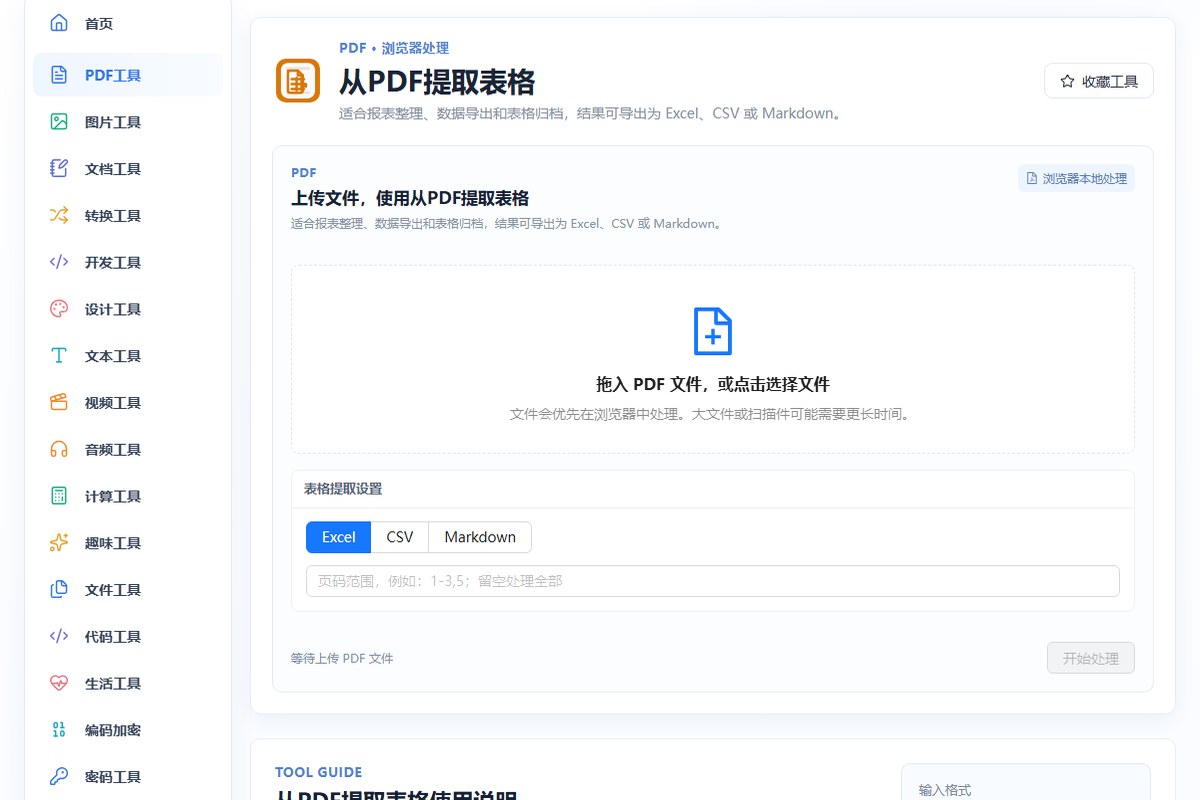
文件在浏览器本地处理,不上传服务器,处理内部报表也放心:
接着可能用得上
扫描版 PDF 的先做图片文字识别;表格里只有一部分要留,可以用Excel 转 JSON转成结构化数据再筛;想要 PDF 里的图而不是表,用从PDF提取图片。
最后提醒:工具负责把格子还原,数据对不对还得你自己核。这两件事别混。