帮人处理报销单,二十几张发票照片要录金额。用识别工具跑了一遍,三十多个金额里错了四个,全是把 8 认成 3、把 0 认成 8。
这不是工具不行。发票照片是斜着拍的,右下角还有一片阴影,这种输入下任何识别引擎都容易出错。
准确率的大头在原图
识别引擎的能力有上限,但大多数时候我们根本没让它发挥出来。三个前置动作,效果比换工具明显:
- 摆正。手机拍的时候尽量垂直俯拍,拍歪了先用裁剪工具转正。
- 提对比。光线不匀、有阴影的,先调一下亮度对比,让字和底分开。
- 去掉无关区域。把桌面、手指、边框裁掉,只留文字区,识别速度也会快一截。
这三步做完再识别,同一张图的结果经常差别很大。
哪些内容注定会错
有些东西再好的工具也搞不定,提前知道能省很多返工:
- 手写体。工整的还行,连笔的基本全错。
- 小字号和密集表格。一张 A4 塞满表格,字号小到 6pt,识别出来会串行。
- 数学公式和特殊符号。上下标、根号、希腊字母,识别成普通文字的概率很高。
- 艺术字和印章压字。文字被红色印章盖住的部分,多半丢字。
遇到这些,与其反复调参数,不如直接人工录入那几处。
识别完必须核的三处
全篇通读很费时间,按优先级抽查更实际:
- 数字。金额、日期、编号。数字错一个字符就全错,而且最难肉眼发现。
- 形近字。0 和 O、1 和 l、日 和 目、己 和 已。
- 换行位置。一行文字被拆成两行后,段首段尾容易多字少字。
推荐工具
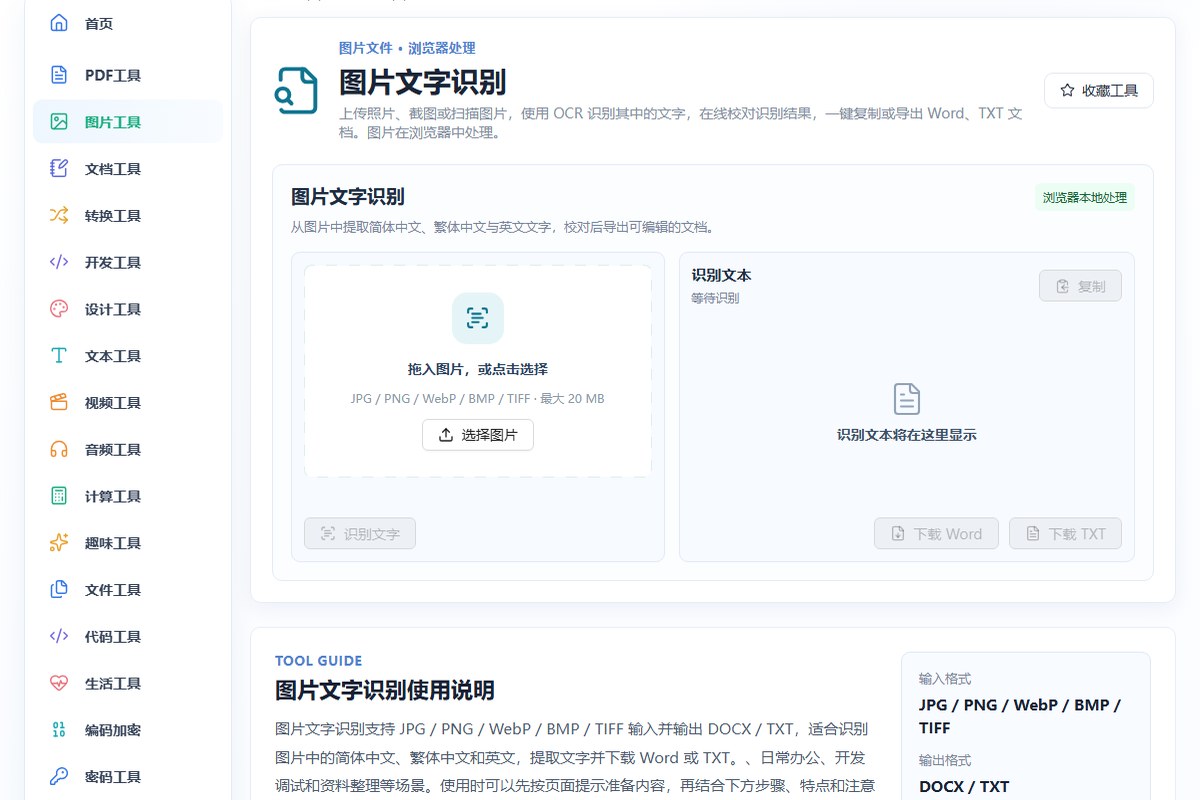
识别结果可以直接复制,也能导出成文本继续编辑: