朋友在小区门口开了家小超市,每个月跟供应商对账,对方发来的不是 Excel,是二十多张手机拍的送货单。她以前的流程是左手划照片、右手敲键盘,四个多小时才能录完,还经常把某一行的数字敲错一位。
后来我们把照片统一丢进图片转Excel,先识别再校对,同样一批单子四十分钟左右收工。这篇把过程和踩过的坑记下来,省得你从头试一遍。
它到底做了什么
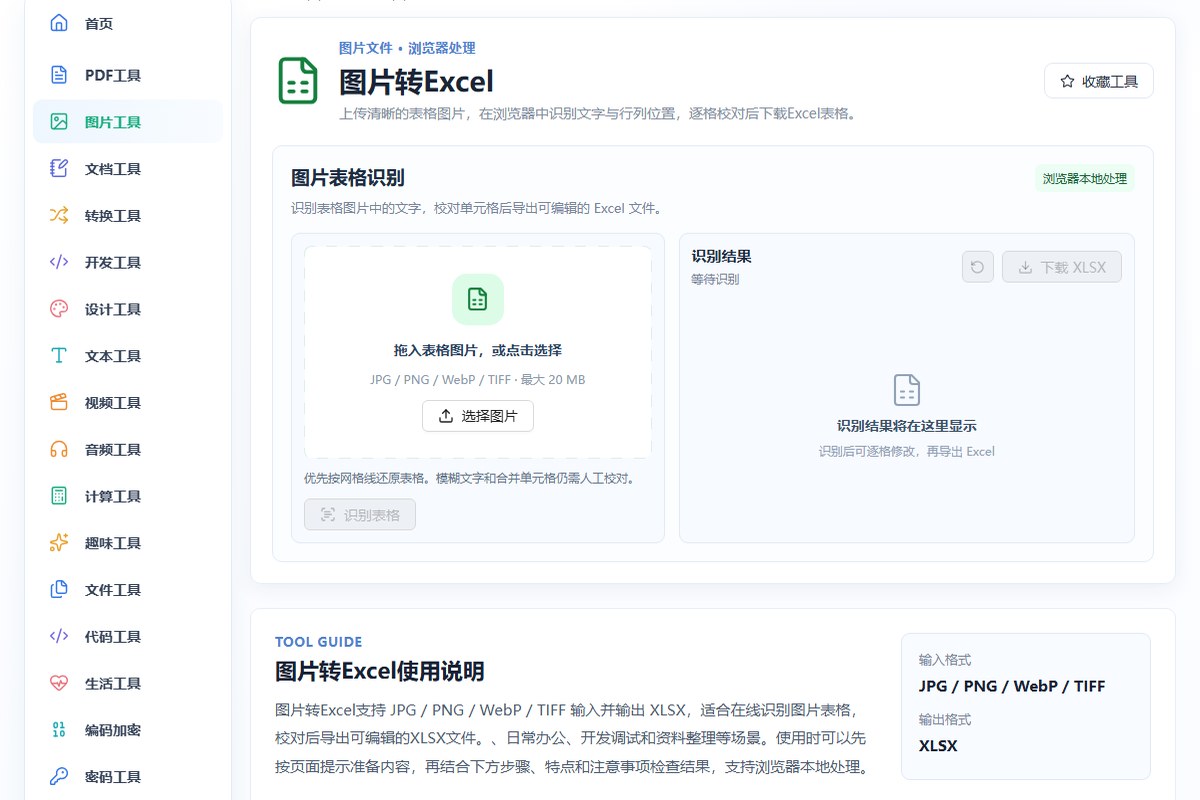
简单说就三步:认出图片里的字,判断这些字落在哪一行哪一列,最后还原成一张能编辑的 XLSX。它不理解业务,不知道单价乘数量应该等于金额,也不会替你检查合计对不对。所以它更像一个手脚麻利的录入员,核对的活还是你的。
搞清楚这一点,后面的期待就不会跑偏。
什么样的照片能识别
结果好不好,八成取决于照片本身。下面几条是最影响成功率的:
- 尽量正对拍摄,手机和纸面平行。斜着拍,表格会变成梯形,列容易对错位。
- 光线均匀,躲开顶灯反光。反光那一片的字,人眼都看不清,别指望识别出来。
- 一张图只放一张表。上下两张表拍进同一张图,行列很容易被接在一起。
- 字别太小。整页拍下来、字只有蚂蚁大的那种,错误率会明显上升。
反过来,手写台账、褶皱严重、密集合并单元格的表(考勤表、复杂报价单),建议直接放弃识别。改错的时间比手打还长,这一点我试过。
操作流程:上传、识别、校对、导出
第一次打开页面会先下载一个识别模型,体积不小,网速一般的话要等一两分钟。这一步只做一次,之后走浏览器缓存,别以为是页面卡住了。
- 把照片拖进上传区。支持 JPG、PNG、WebP、TIFF,单张不超过 20MB。
- 点「识别表格」,等结果出来。整页内容会按位置还原成行列。
- 逐格校对。这一步别省,具体看下面。
- 确认无误后下载 XLSX,用 Excel 或 WPS 打开就能接着算。
校对重点看这四处
OCR 的错误是有规律的,不是随机错。按这个顺序扫一遍,比从头逐字看快得多:
- 数字:0 和 O、1 和 l、5 和 S 最容易混,金额列必须逐个过。
- 小数点:被识别成逗号或者干脆丢掉,268.00 变成 26800,合计就全错了。
- 合并单元格:跨列的表头,识别后通常只剩第一格有值,需要手动补。
- 合计行:有些单据底部是手写合计,识别出来会挤在最后一列。
一个省时间的办法:先看合计。原单上有合计金额的,把识别结果求和跟它比一下,对不上再回头找差异行,比从头核对快很多。
推荐工具
下面这张卡片点进去就是工具页,手机上也能直接用,不用装软件:
相关工具组合
识别只是第一步,后面这些能接上:照片拍歪了,先用图片裁剪把表格区域裁正再识别,准确率会好一截;拿到的表格要转成接口能用的数据,可以走Excel 转 JSON;如果原始数据本来就是 CSV,直接CSV 转 Excel更快,没必要拍照。
两个常见问题
图片会上传到服务器吗?
不会。识别在浏览器本地完成,图片不出本机。这也是第一次用要下载模型的原因。
识别出来是图片不是表格,怎么回事?
通常是照片太糊,或者表格线本身不明显。换一张更清楚的图,或者把原始文件平铺重拍一次,一般就能解决。
最后说句实在话:这类工具省的是敲键盘的时间,不是核对的时间。校对那五分钟别省,省下来的是事后返工的半小时。