财务同事昨天发来一个 Excel,打开第一列全是"涓枃"、"鐢靛瓙"这种看不懂的方块字。她说这是从老系统导出的客户名单,导出来就这样。
我让她别改,先把文件另存一份。这类乱码九成不是文件坏了,是编码对不上——数据还在,只是被用错误的字典翻译了一遍。
乱码的本质只有一句话
文字存进文件时是一串字节,读出来时要按同一套编码规则翻译。存的时候用 UTF-8,读的时候当成 GBK,出来的就是"涓枃"这种字。
所以判断乱码能不能救,就看一件事:字节有没有被覆盖。只要是编码错配,换个编码重新读就能恢复;如果中间被存过一次,字符变成问号或空白,那就真丢了。
按来源分四种情况
一、网页复制粘贴出来的
网页本身声明的编码和浏览器实际用的编码不一致。这种情况刷新页面、确认浏览器编码设置通常能解决,粘出来之前先看一眼页面显示是否正常。
二、CSV 文件用 Excel 打开
最常见的一种。CSV 本身没有编码标记,Excel 在中文系统里默认按 GBK 读,遇到 UTF-8 文件就全乱。
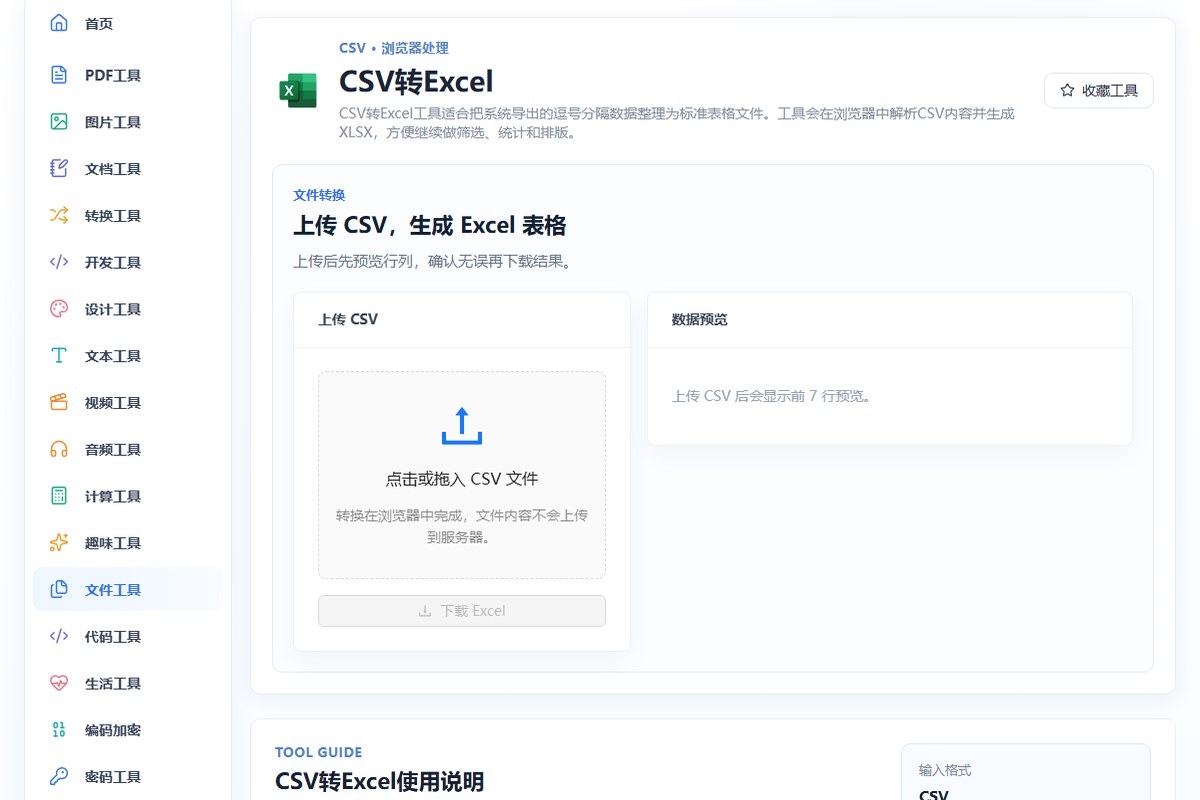
解法有两个:一是用 Excel 的"数据 → 从文本/CSV"导入,导入向导里手动选 UTF-8;二是先用工具把 CSV 转成 xlsx,转换过程会显式指定编码,之后打开就不会乱。
三、接口返回的数据
接口返回头里写着 charset=gbk,但内容其实是 UTF-8,或者反过来。这种要改代码,把解码方式对齐,页面端改不了。
四、URL 里的中文参数
浏览器会把中文转成百分号编码再发出去。如果服务端用错了解码方式,拿到的就是乱码。这种情况看 URL 里是 %E4%B8%AD 这类三段式还是 %D6%D0 这类两段式,就能判断是 UTF-8 还是 GBK。
怎么确认是哪种编码
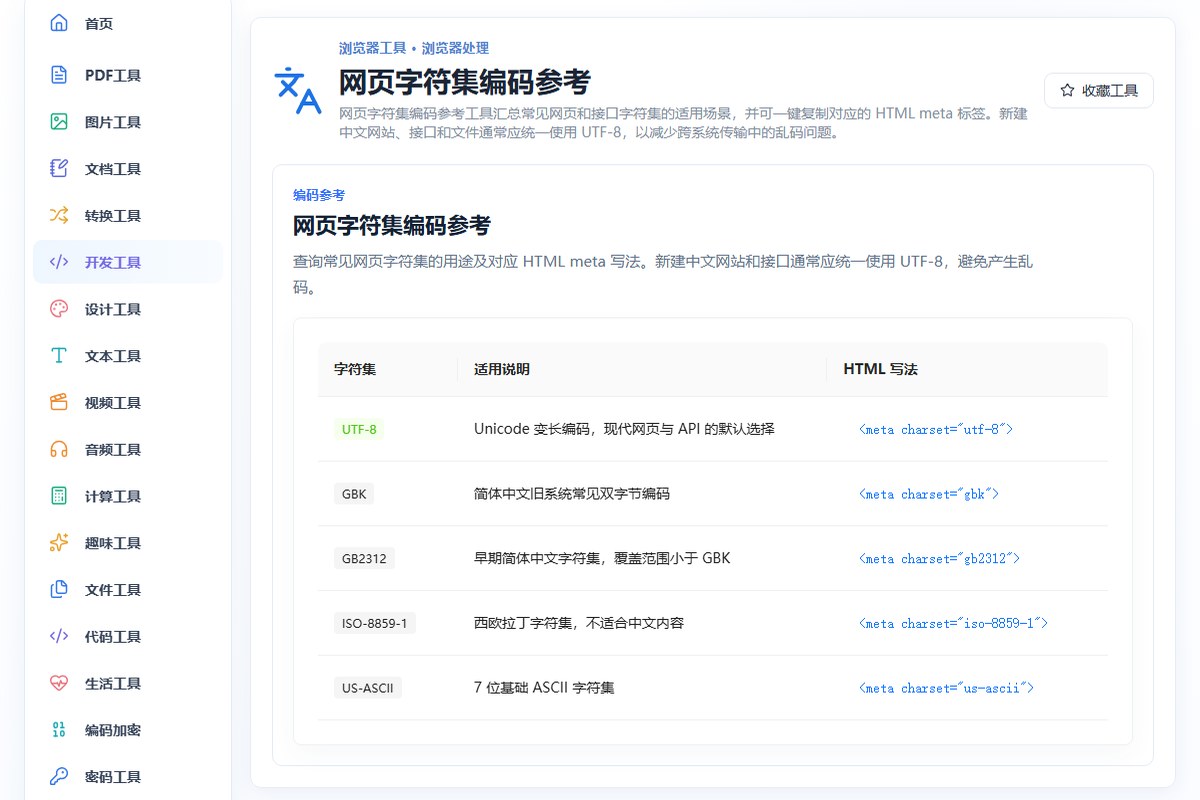
不用背规则,对着表看特征就行。UTF-8 的中文一般是三个字节一组,百分号编码里连着三个 %;GBK 是两个字节一组。乱码里如果出现大量生僻字和奇怪符号混排,基本是 UTF-8 被当 GBK 读了。